우아콘 2023에서 살펴본 Spring WebFlux 도입기
배민스토어의 WebFlux 적용 사례를 바탕으로 논블로킹 처리, 배압, 러닝 커브를 정리합니다.
이 글은 우아콘 2023의 배민스토어 WebFlux 도입 사례를 보고 정리한 노트입니다. 아래 경험과 판단은 발표 사례에 대한 요약이며, 필자의 서비스에서 직접 측정한 결과가 아닙니다.
WebFlux와 리액티브 프로그래밍
Spring WebFlux는 Spring 5에 추가된 웹 프레임워크로, 리액티브 스트림과 논블로킹 I/O를 활용할 수 있습니다. Project Reactor가 제공하는 Mono와 Flux는 각각 01개와 0N개의 값을 비동기적으로 다루는 Publisher 타입입니다.
논블로킹은 작업의 완료를 기다리는 동안 실행 스레드가 해당 작업에 묶이지 않도록 하는 방식입니다. 여러 외부 I/O를 기다리는 요청에서 스레드 사용을 줄이거나 호출을 조합할 수 있지만, 모든 작업이 자동으로 빨라지는 것은 아닙니다. 애플리케이션의 호출 패턴과 사용하는 라이브러리가 실제로 논블로킹인지 함께 확인해야 합니다.
오류와 대체 조회를 연산자로 표현하기
발표에서는 캐시 조회에 실패하거나 결과가 없을 때 DB를 조회하는 흐름을 명령형 코드와 Reactor 연산자로 대비합니다.
shopCacheRepository.findById(shopId)
    .doOnError { error -> log.error("Received error on shop cache.", error) }
    .onErrorComplete()
    .switchIfEmpty { shopDBRepository.findById(shopId) }
Reactor에서는 예외, 빈 결과, 대체 흐름을 각각 다른 연산자로 조합합니다. 연산자의 동작을 정확히 이해해야 하므로 익숙하지 않은 팀에는 학습 비용이 생깁니다.
외부 API 호출이 많은 전시 서비스
발표에서 소개한 도입 배경 중 하나는 전시 요청에서 실시간으로 호출하는 외부 API가 늘어난 점입니다. 블로킹 호출은 응답을 기다리는 동안 스레드를 점유합니다. 논블로킹 호출을 사용하면 I/O 대기 중 스레드를 다른 작업에 쓸 여지가 생기고, 독립적인 요청을 병렬로 조합해 응답 시간을 줄일 수 있습니다.
Mono.zip(
    productService.getProductDetail(...),
    productService.getProductOption(...),
    promotionService.findActivePromotions(...)
).map { (product, options, promotions) ->
    // 응답 구성
}
발표 사례에서는 WebFlux를 전시 API에 우선 적용하고, 복잡성이 불필요한 배치성 로직과 어드민·워커에는 도입하지 않는 선택을 했습니다. 도입 범위를 좁혀 학습 비용과 복잡성을 관리하려는 접근입니다.
배압은 언제 중요할까?
Reactive Streams의 배압(backpressure)은 소비자가 처리할 수 있는 양에 맞춰 Publisher가 데이터를 전달하도록 수요를 조절하는 프로토콜입니다. Publisher가 무조건 데이터를 밀어 넣고 Subscriber가 버퍼를 쌓다가 멈추는 기능으로만 이해하면 정확하지 않습니다. 실제 동작은 Publisher와 연산자, 구독자가 수요를 어떻게 전달하는지에 따라 달라집니다.
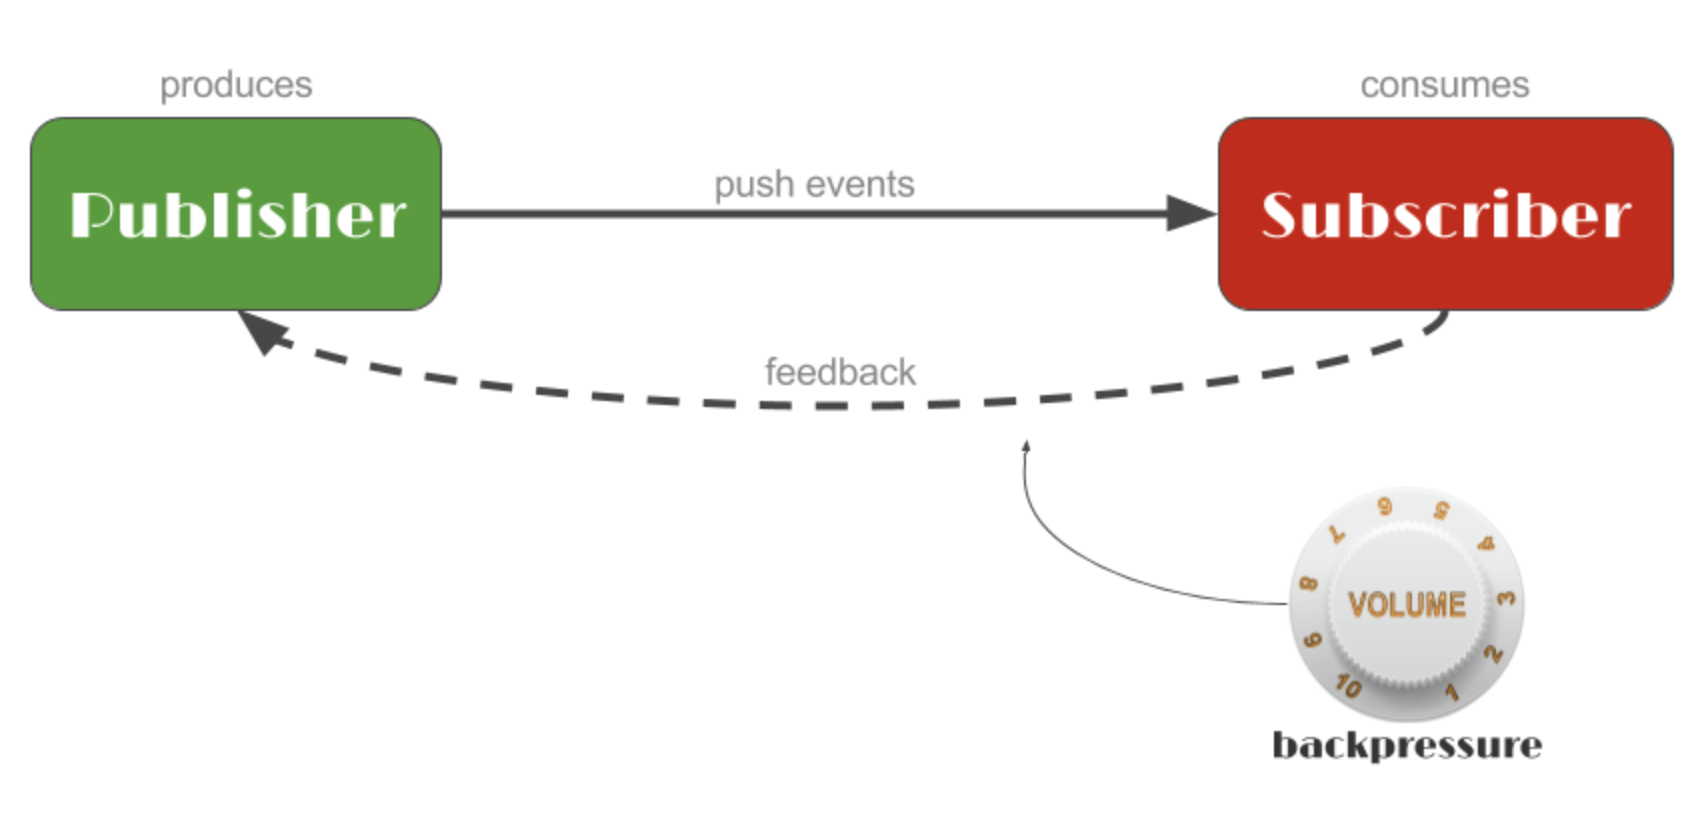
Flux<String> dataStream = Flux.range(1, 100)
    .map(i -> "Item " + i);

dataStream
    .onBackpressureBuffer(10)
.subscribe(item -> System.out.println("Processing " + item));onBackpressureBuffer(10)은 수요를 처리할 수 없는 상황에서 요소를 버퍼링하도록 하는 연산자입니다. 버퍼가 가득 찼을 때의 오버플로 동작도 함께 고려해야 하며, 버퍼를 붙였다고 생산자가 항상 멈추는 것은 아닙니다.
발표에서는 일반적인 API가 제한된 수의 외부 호출 결과를 Mono로 조합하는 경우가 많아 배압의 이점이 두드러지지 않을 수 있다고 설명합니다. 반면 배치 작업에서는 Kafka 이벤트나 페이지네이션으로 많은 데이터를 처리하고, 외부 플랫폼 호출 속도 제한에 맞춰 요청량을 제어해야 하므로 Reactor 연산자가 유용할 수 있습니다.
예를 들어 커서 페이지네이션으로 다음 페이지를 읽는 시점이나, 큰 데이터 집합을 작은 묶음으로 나눠 일정 속도로 외부 시스템에 보내는 흐름을 리액티브 연산자로 구성할 수 있습니다. 다만 적절한 배압 전략과 버퍼 크기는 생산자·소비자의 특성을 보고 결정해야 합니다.
성능과 생산성은 어떻게 확인할까?
발표에서는 더 많은 요청을 받으면서도 응답이 빨라졌고, 여러 데이터를 병렬로 가져오는 일이 자연스러워졌다는 경험을 공유했습니다. 동시에 Spring MVC와 WebFlux를 같은 조건에서 비교한 통제 실험은 아니어서, 성능이나 자원 효율 개선을 WebFlux만의 효과로 단정하지 않았습니다.
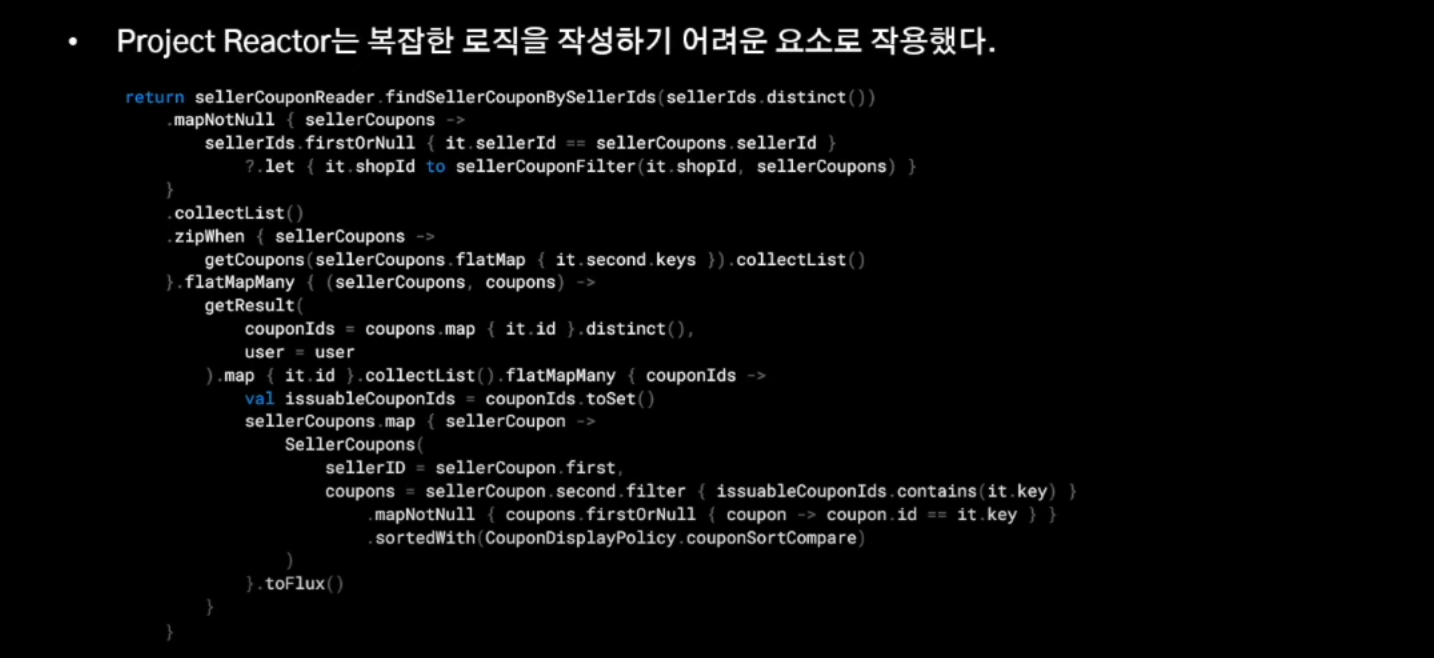
또한 팀 내 스터디와 노하우 공유에도 Reactor의 높은 러닝 커브와 잔존하는 이슈가 생산성에 영향을 주었다고 설명했습니다. 기술 도입 전후를 비교할 때는 부하 조건과 호출 수, 응답 시간, CPU·메모리, 장애 대응 비용 등을 함께 살펴야 합니다.
정리
- 논블로킹은 I/O 대기 중 스레드를 점유하지 않는 데 도움을 주지만, 전체 작업의 성능 향상을 자동으로 보장하지는 않습니다.
- 여러 독립적인 외부 호출을 조합하거나 대량의 데이터 흐름을 제어해야 할 때 WebFlux와 Reactor가 유용할 수 있습니다.
- 리액티브 연산자와 디버깅에 대한 학습 비용이 있으므로, 팀의 숙련도와 서비스 요구에 맞춰 적용 범위를 정하는 것이 중요합니다.
- 도입 효과는 통제된 측정과 운영 경험으로 검증해야 합니다.