Java 컬렉션별 연산 시간 복잡도 정리
ArrayList, LinkedList, Map, Set의 구조와 조회·삽입·삭제 비용을 비교하고 선택 기준을 정리합니다.
시간 복잡도 먼저 보기
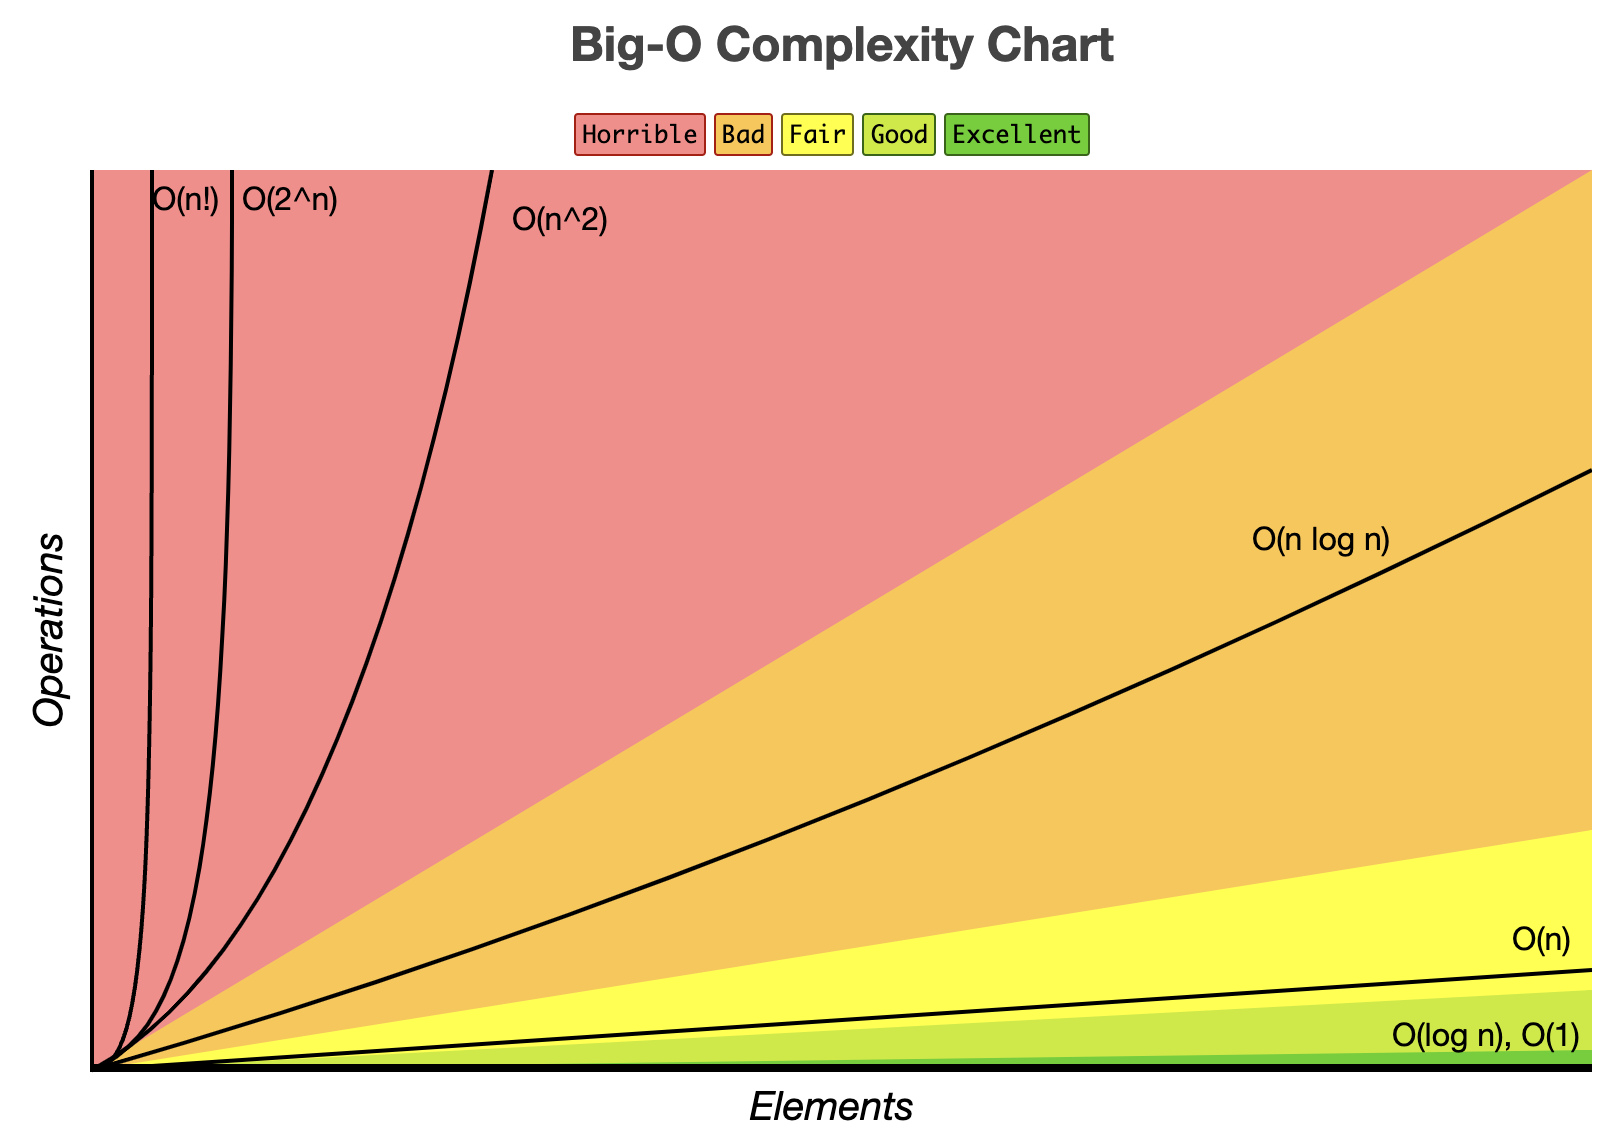
입력 크기 N이 커질 때 연산 횟수가 어떻게 늘어나는지를 표현하는 것이 시간 복잡도입니다. 일반적으로 O(1), O(log N), O(N), O(N²), O(Cᴺ) 순으로 입력 크기가 커질수록 부담이 커집니다. 이는 실행 시간을 밀리초로 직접 예측하는 수치가 아니라 증가율을 비교하는 표기입니다.
List
ArrayList
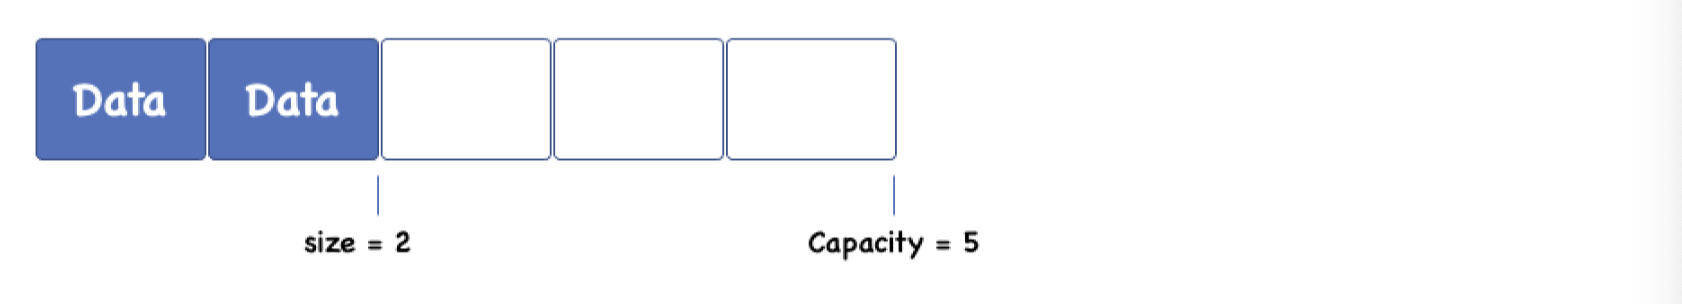
ArrayList는 배열을 바탕으로 요소를 저장합니다. 인덱스로 접근하는 조회는 O(1)이고, 값 검색은 순차 비교로 인해 O(N)입니다. 끝에 추가하는 연산은 보통 O(1)이며, 내부 배열을 늘리는 시점에는 복사가 발생해 O(N)이 들 수 있습니다. 처음이나 중간에 삽입·삭제하면 뒤의 요소를 이동해야 하므로 O(N)입니다.
ArrayList<String> names = new ArrayList<>();
names.add("May");
names.add("Jane");
String first = names.get(0); // 인덱스 조회
LinkedList
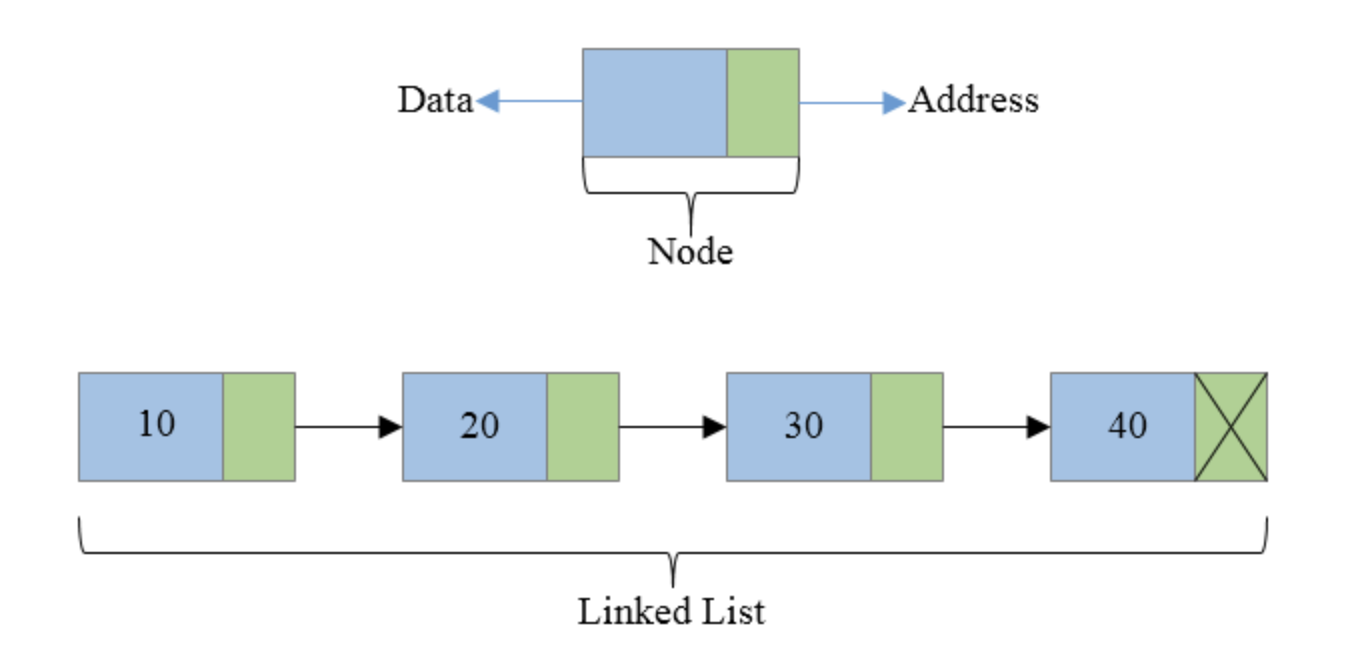
Java의 LinkedList는 이전·다음 노드를 가리키는 이중 연결 구조입니다. 임의 인덱스 조회와 검색은 노드를 찾아가야 하므로 O(N)입니다. 이미 위치를 알고 있을 때 노드 연결을 바꾸는 작업은 O(1)이지만, 인덱스로 중간 위치를 찾는 비용까지 포함하면 삽입·삭제는 일반적으로 O(N)입니다. 맨 앞·뒤 연산은 O(1)입니다.
LinkedList<String> names = new LinkedList<>();
names.addFirst("May");
names.addLast("Jane");
names.removeFirst();
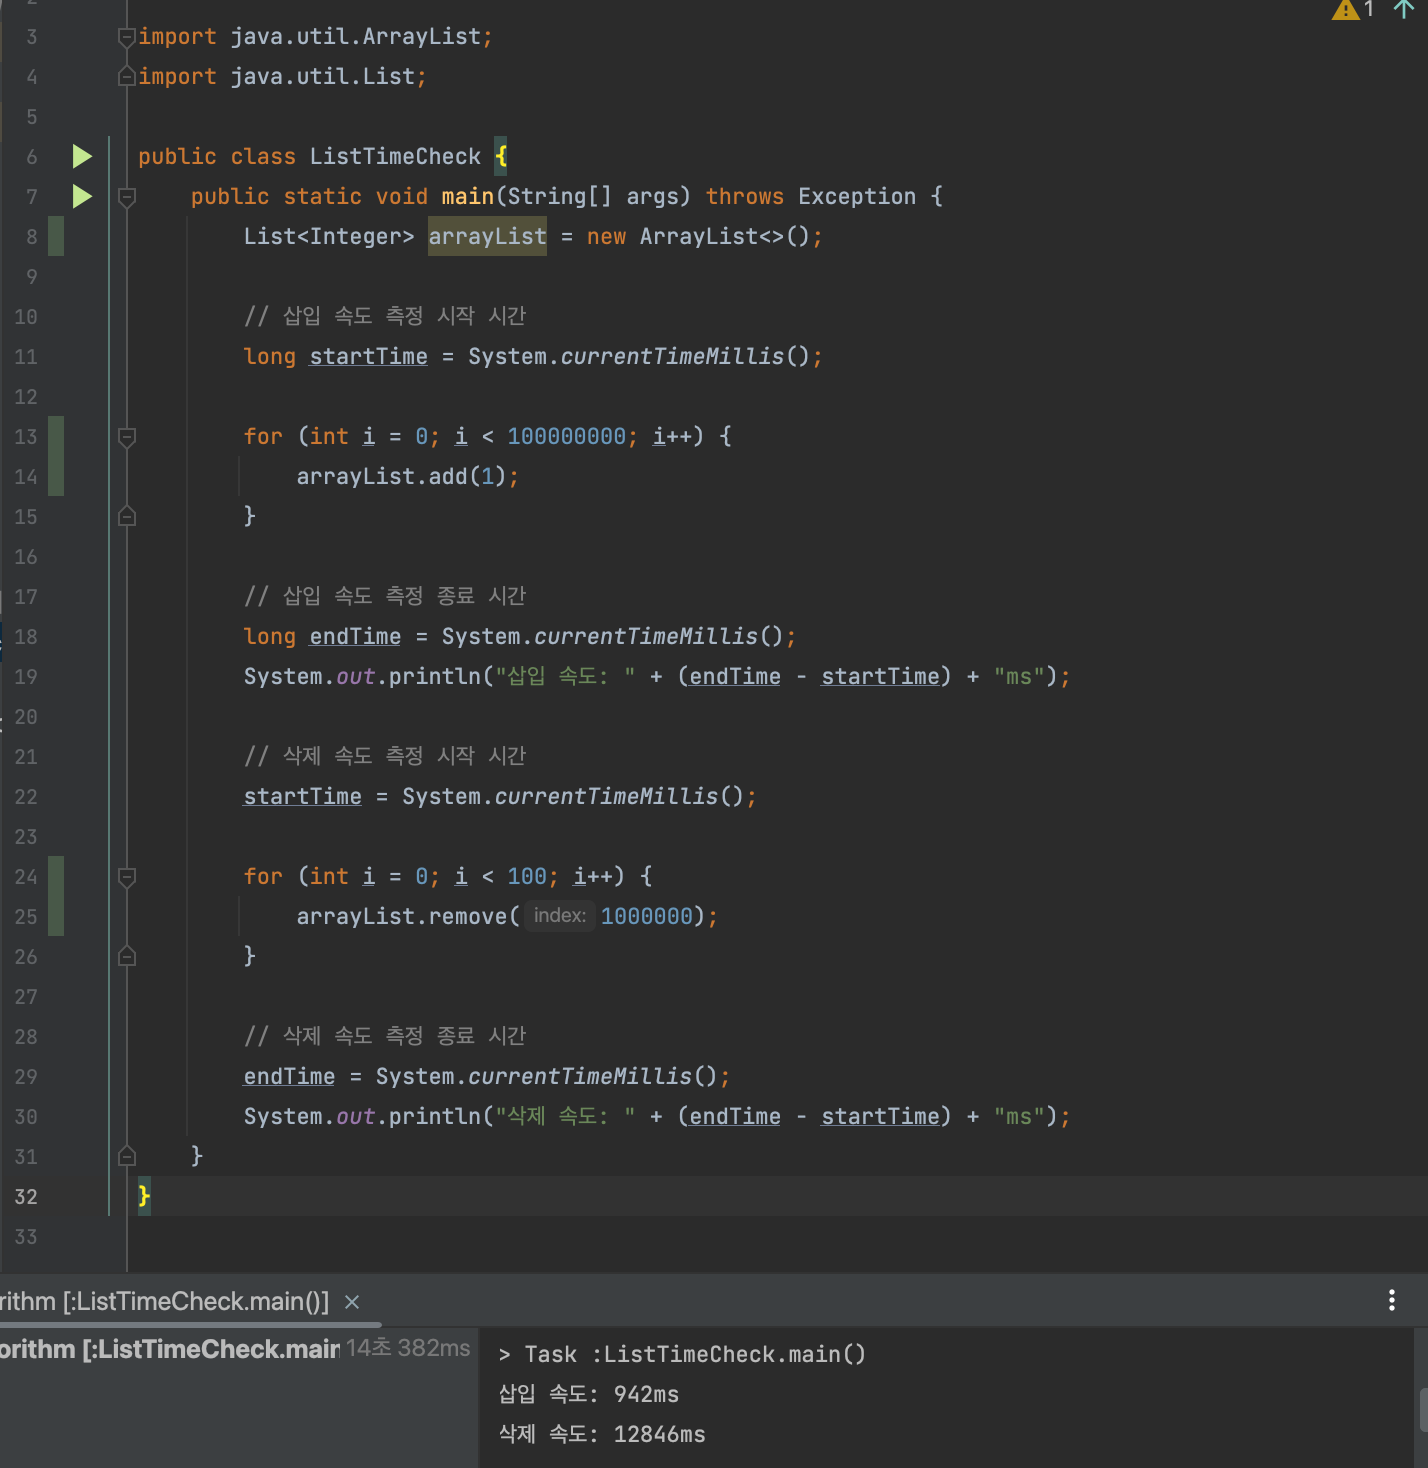
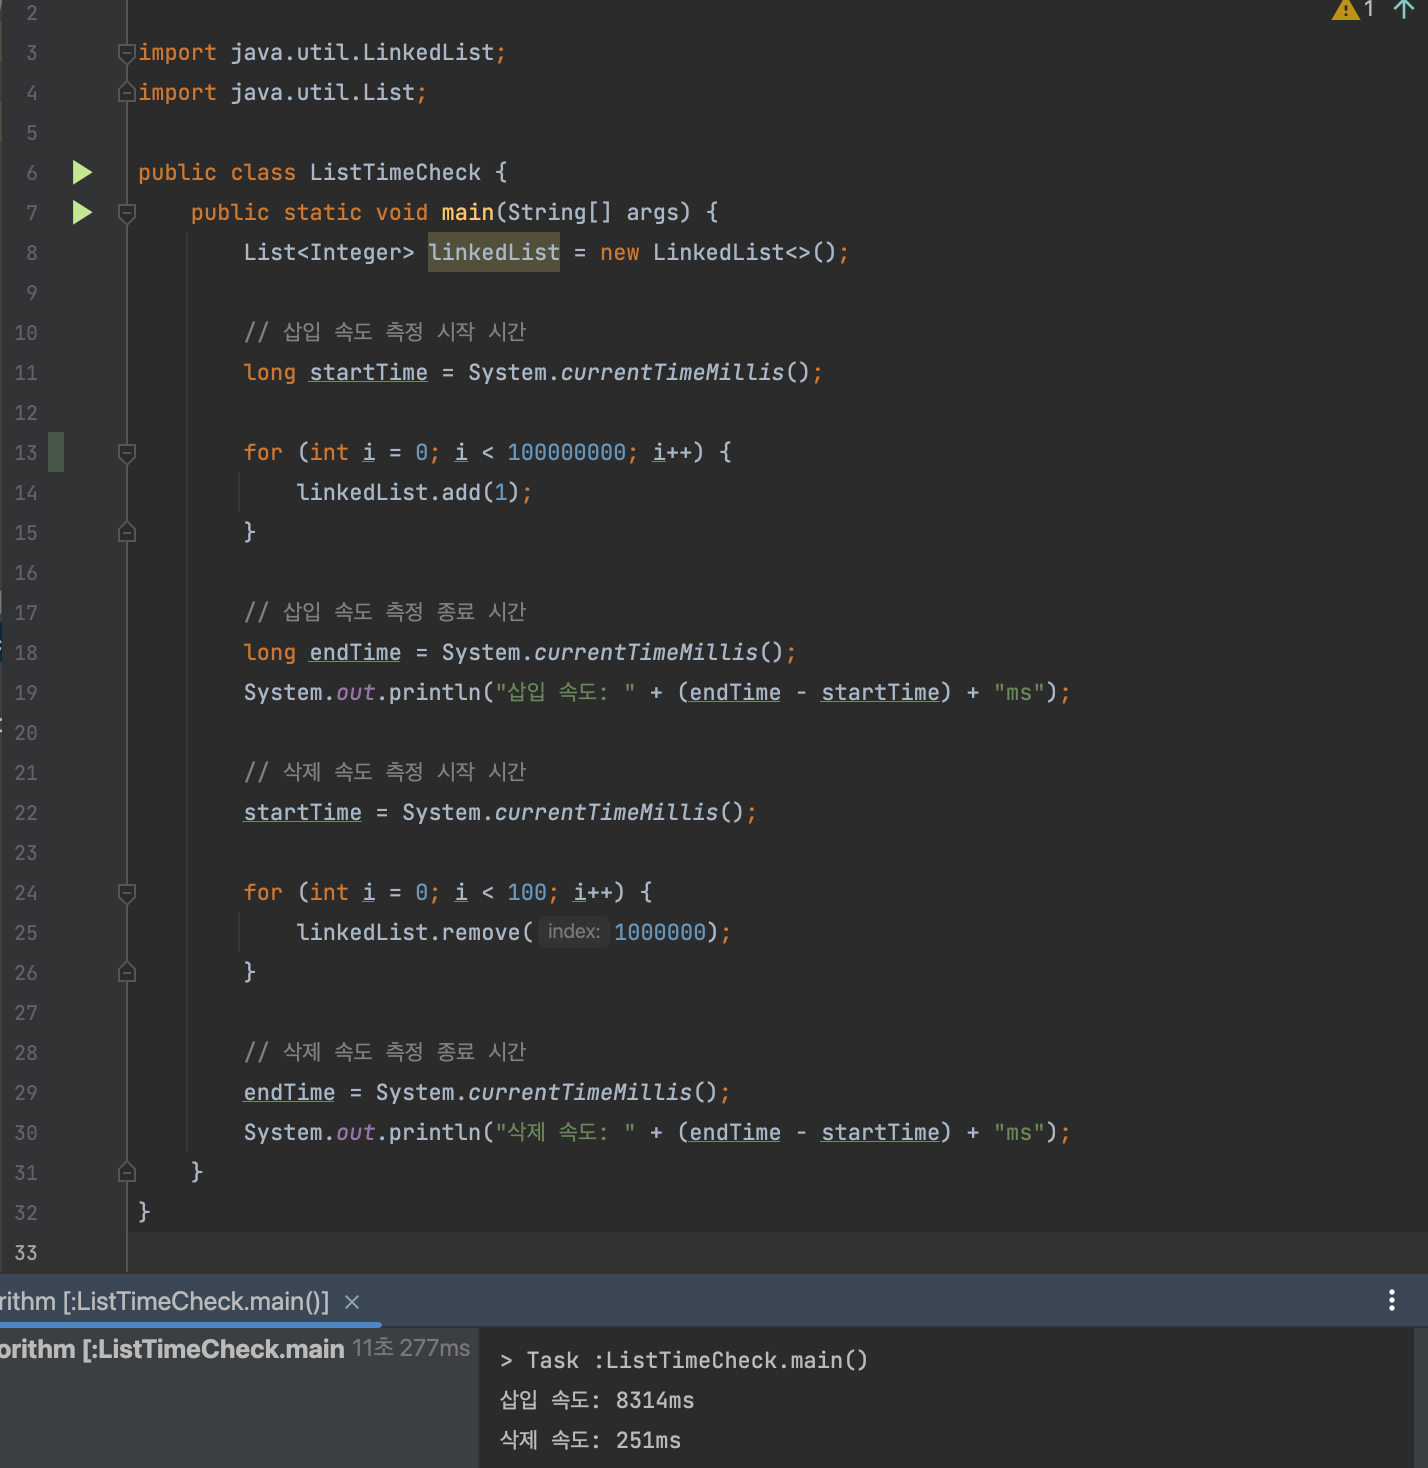
ArrayList와 LinkedList를 각각 많은 요소로 실험한 원문에는 삽입·삭제 시간이 기록되어 있습니다. 다만 실행 환경과 구현 세부사항이 함께 제시되지 않았으므로, 그 숫자를 일반적인 성능 기준으로 적용하기보다는 실제 사용 데이터와 연산 패턴에 맞춰 측정하는 편이 좋습니다.
Map
HashMap
HashMap은 키와 값을 연결해 저장하고, 해시를 이용해 키로 값을 찾습니다. 조회·삽입·삭제는 평균적으로 O(1)이며 키가 해시 충돌을 일으키거나 재해시가 발생하는 상황에서는 비용이 더 커질 수 있습니다. 순서를 보장하지 않습니다.
Map<String, Integer> scores = new HashMap<>();
scores.put("apple", 10);
scores.put("banana", 20);
scores.put("apple", 30); // 같은 키의 값을 교체

int appleScore = scores.get("apple");
boolean containsApple = scores.containsKey("apple");
scores.remove("banana");
서로 다른 키의 해시값이 같은 버킷에 모이면 충돌이 발생합니다. Java 8 이후 HashMap은 특정 조건에서 긴 버킷을 트리 구조로 바꿔 충돌 상황의 탐색 비용을 줄일 수 있습니다. 따라서 평균 O(1)을 최악의 경우까지 보장하는 표현으로 오해하지 않는 것이 중요합니다.
TreeMap
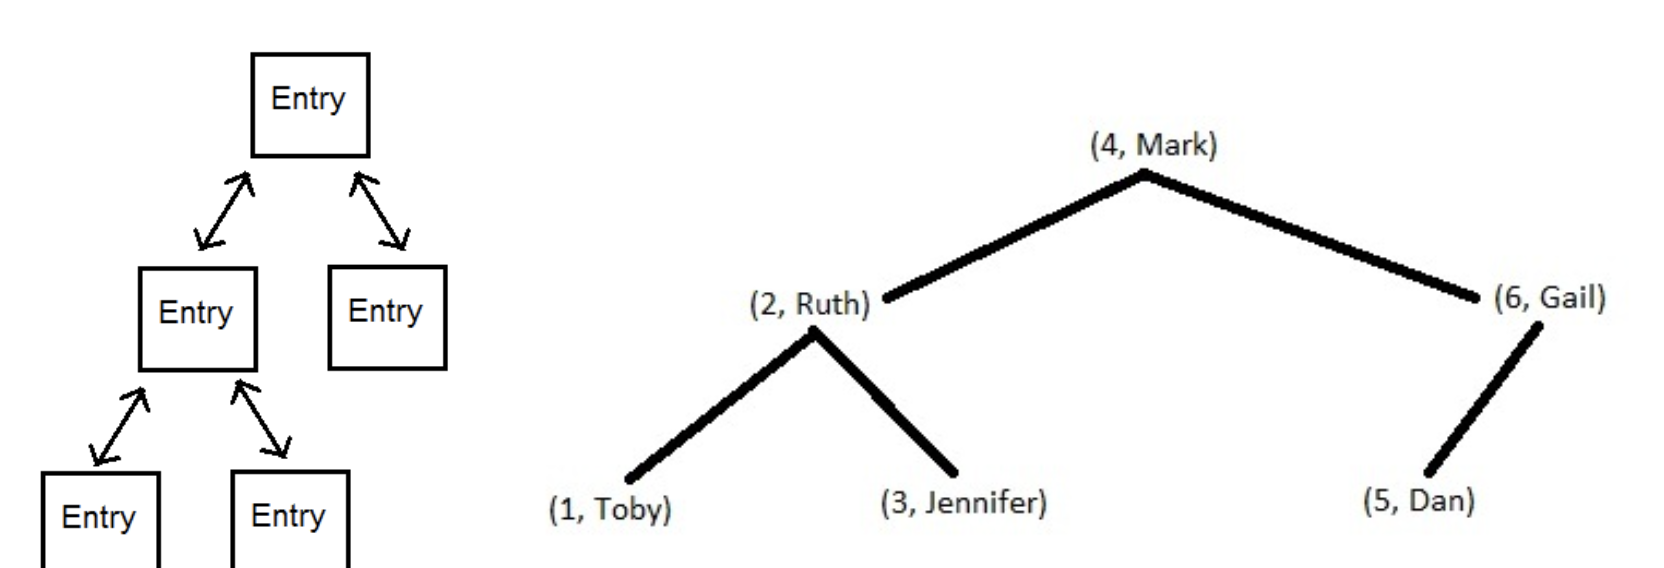
TreeMap은 정렬된 키 순서를 유지하는 NavigableMap 구현체입니다. 키를 기준으로 정렬하며, 조회·삽입·삭제는 균형 이진 탐색 트리의 높이에 비례해 O(log N)입니다. 범위 검색이나 정렬된 순회가 필요할 때 선택할 수 있습니다.
TreeMap<Integer, String> names = new TreeMap<>();
names.put(3, "Three");
names.put(1, "One");
names.put(2, "Two");

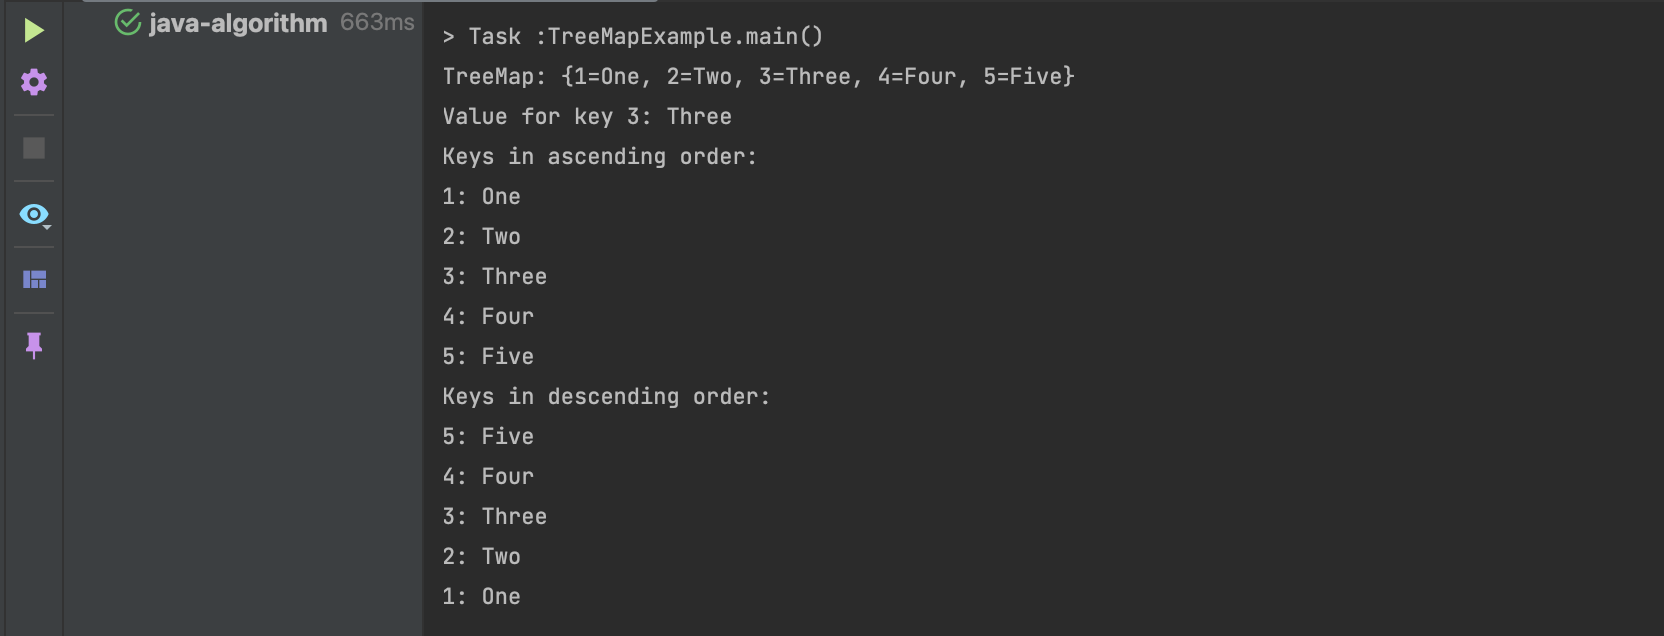
System.out.println(names); // 키 오름차순
System.out.println(names.descendingMap());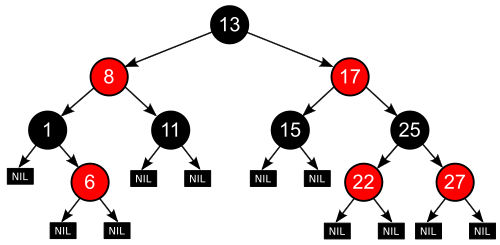
Set
Set은 중복 요소를 허용하지 않는 컬렉션입니다.
HashSet
HashSet은 해시 기반으로 요소를 저장하며 삽입·삭제·포함 여부 확인이 평균 O(1)입니다. 요소의 순서를 보장하지 않습니다. 인덱스로 특정 요소를 조회하는 기능은 없습니다.
Set<String> animals = new HashSet<>();
animals.add("tiger");
animals.add("lion");
animals.remove("lion");
boolean containsTiger = animals.contains("tiger");
TreeSet
TreeSet은 정렬된 순서를 유지하며 중복을 허용하지 않습니다. 삽입·삭제·포함 여부 확인은 O(log N)입니다. 범위에 해당하는 요소를 찾거나 정렬 순서대로 순회해야 할 때 사용할 수 있습니다.
TreeSet<Integer> values = new TreeSet<>();
values.add(5);
values.add(3);
values.add(7);
values.remove(3);
boolean containsFive = values.contains(5);
컬렉션 선택 기준
| 필요 작업 | 고려할 컬렉션 | 대표 비용 |
|---|---|---|
| 인덱스로 빠르게 조회 | ArrayList |
조회 O(1) |
| 맨 앞·뒤에서 자주 추가·삭제 | LinkedList |
양 끝 연산 O(1) |
| 키로 값을 빠르게 찾기 | HashMap |
평균 조회 O(1) |
| 키 정렬이나 범위 조회 | TreeMap |
연산 O(log N) |
| 중복 제거, 빠른 포함 확인 | HashSet |
평균 확인 O(1) |
| 중복 없이 정렬 유지 | TreeSet |
연산 O(log N) |
Big-O 표기만으로 실제 속도를 단정하기는 어렵습니다. 요소 수, 메모리 사용량, 데이터의 분포, 필요한 순서, 실제 호출 패턴까지 함께 고려해 선택합니다.